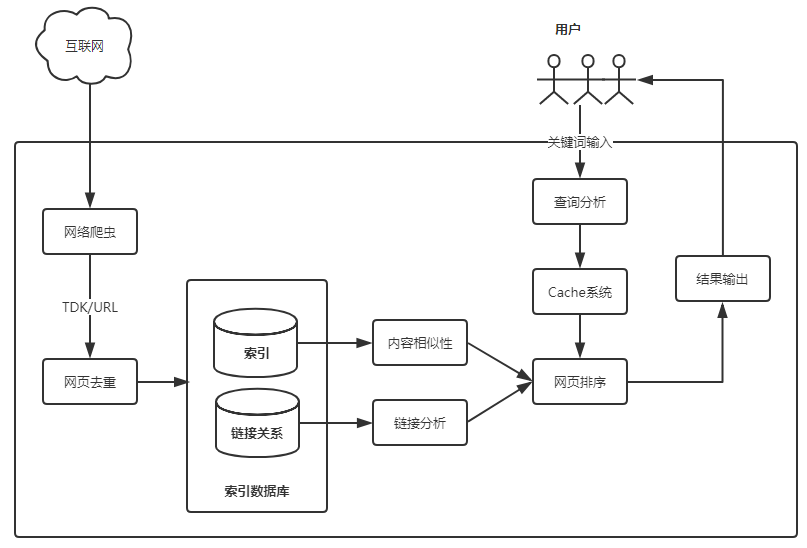
搜索引擎架构及运行原理
搜索引擎架构及运行原理
1 – 在启动grub菜单,选择编辑选项启动
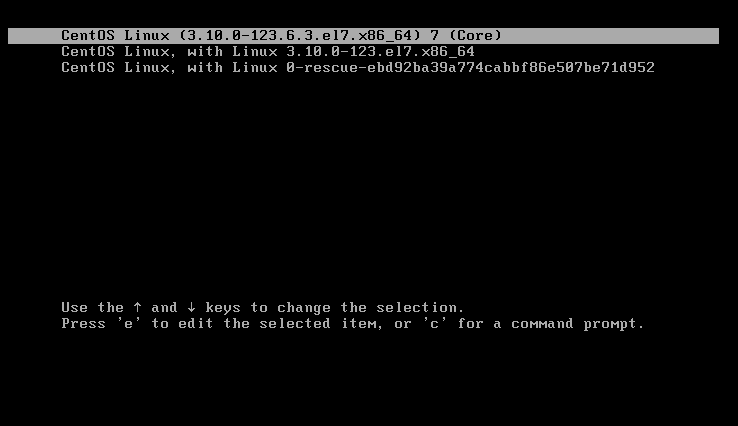
2 – 按键盘e键,来进入编辑界面
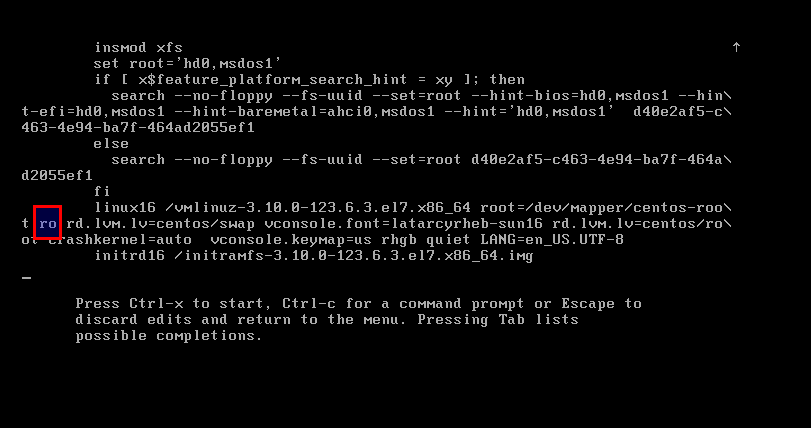
3 – 找到Linux 16的那一行,将ro改为rw init=/sysroot/bin/sh
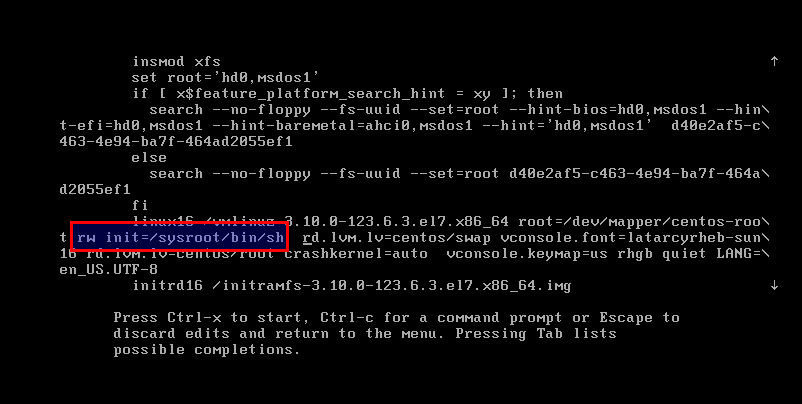
4 – 现在按下 Control+x ,使用单用户模式启动
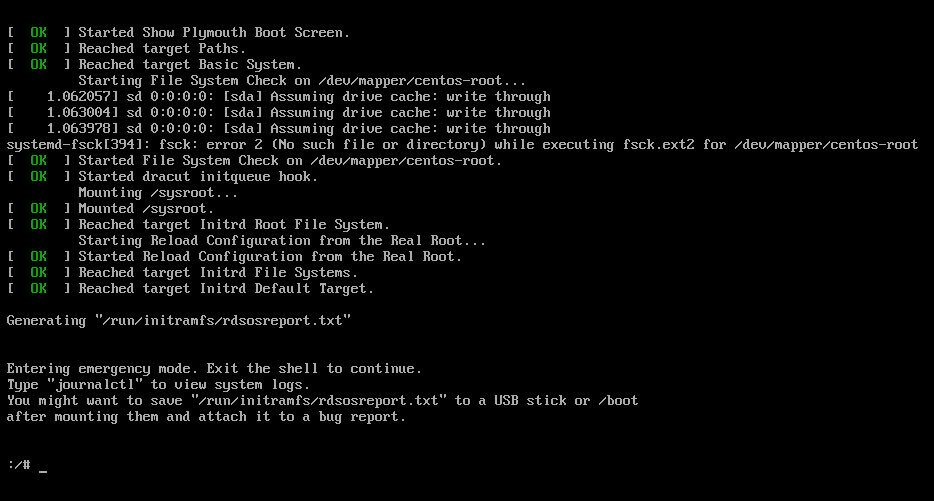
5 – 现在,可以使用下面的命令访问系统
chroot /sysroot
6 – 重置密码
passwd root
7 – 更新系统信息
touch /.autorelabel
8 – 退出chroot
exit
9 – 重启你的系统
reboot
就是这样!
via: http://www.unixmen.com/reset-root-password-centos-7/
作者:M.el Khamlichi 译者:su-kaiyao 校对:wxy
本文由 LCTT 原创翻译,Linux中国 荣誉推出
永久的开放需要的端口
sudo firewall-cmd --zone=public --add-port=3000/tcp --permanent
sudo firewall-cmd --reload
之后检查新的防火墙规则
firewall-cmd --list-all
由于只是用于开发环境,所以打算把防火墙关闭掉
//临时关闭防火墙,重启后会重新自动打开
systemctl restart firewalld
//检查防火墙状态
firewall-cmd --state
firewall-cmd --list-all
//Disable firewall
systemctl disable firewalld
systemctl stop firewalld
systemctl status firewalld
//Enable firewall
systemctl enable firewalld
systemctl start firewalld
systemctl status firewalld1.发现潜在漏洞,先不处理,言之 现在没发生,将来也不一定会发生,等出了问题再说.
2.权责不分,做的时候告诉只要按照要求去做就好了,出了问题就说为啥不想清楚再做
3.拉帮结派
4.一言堂
一边津津有味吃屎,一边骂骂咧咧讲屎臭
一个年轻的姑娘替她的新婚丈夫煮一块火腿。她先把火腿的两头去掉,然后放入锅中,丈夫问她为什么这样做,她回答说,因为她的母亲“一向都如此做”。
1.先通过cefsharp调用js.获取当前登录人信息,总是报错,出现在uncaught referenceerror is not defined 错误.
2.通过页面重新加载,执行加载函数init(),读到登陆信息,失败
3.通过cookie获取,发现cookie里面没有.失败
4.在localStorage中发现有记录登录人姓名信息.谷之.发现chrome的locastorage是通过sqlite读写的,进去发现保存内容为blob.
直接select不行,放弃
5.发现可以用JavaScript的方式直接来读localstorage.
var ss=localStorage[‘login_saveInfo’]; alert(ss);
最终代码
Task<CefSharp.JavascriptResponse> t = browser.EvaluateScriptAsync(“function login(){var ss=localStorage[‘login_saveInfo’]; return ss;} login();”);
// 等待js 方法执行完后,获取返回值t.Wait();
// t.Result 是 CefSharp.JavascriptResponse 对象
// t.Result.Result 是一个 object 对象,来自js的 callTest2() 方法的返回值
if (t.Result.Result != null)
{
//MessageBox.Show(t.Result.Result.ToString());todo();
}
使用winform_cefsharp的搭配处理
1.坐席登陆,通过JS获取到已经登陆到系统的账号信息,再根据坐席分配表获取到对应的坐席信息,连接CTI,登陆坐席.
2.外拨事件:在页面上增加JS函数,参数为需要外拨的号码.JS函数回调C#的外拨功能.拨出电话
3.挂机后.坐席状态改变触发写日志的功能.
多年前写过一个内嵌的浏览器,并做了自动登陆的功能,现在因为要增加部分功能,发现webbrowser 有两个坑
1.默认使用的是IE7的内核,如果想使用高版本的IE,需要修改注册表.这样不利于推广使用
2.随着判断的增多,加载的时间越来越长.
准备 进cefsharp的坑
cefsharp 测试时遇到的几个问题:
1.检测页面加载完成
2.多开页面是重新加载的问题.
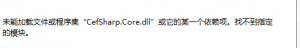
未能加载文件或程序集“CefSharp.Core.dll”或它的某一个依赖项。找不到指定的模块
此报错需要安装C++运行环境(Microsoft Visual C++ 2013 Redistributable (x86) ) 就算本地系统是64位的,运行环境也是要装X86的
下载地址: https://www.microsoft.com/zh-CN/download/details.aspx?id=40784
QPS每秒查询率(Query Per Second)
每秒查询率QPS是对一个特定的查询服务器在规定时间内所处理流量多少的衡量标准,在因特网上,作为域名系统服务器的机器的性能经常用每秒查询率来衡量。对应fetches/sec,即每秒的响应请求数,也即是最大吞吐能力。 (看来是类似于TPS,只是应用于特定场景的吞吐量),QPS 其实是衡量吞吐量(Throughput)的一个常用指标,就是说服务器在一秒的时间内处理了多少个请求 —— 我们通常是指 HTTP 请求,显然数字越大代表服务器的负荷越高、处理能力越强。作为参考,一个有着简单业务逻辑(包括数据库访问)的程序在单核心运行时可以提供 50 – 100 左右的 QPS,即每秒可以处理 50 – 100 个请求。
但 QPS 只能粗略地衡量请求的数量,完全不关心服务器处理每个请求的开销。例如一个命中缓存的请求和一个需要进行多次数据库查询的请求的开销可能会有一个数量级的差距,所以 QPS 并不能十分精确地衡量服务器的负载或处理能力,因此我们引入了一个非常抽象的概念 —— 并发。
大部分请求的响应时间在 15 – 30 毫秒左右,这里的响应时间是指服务器处理这个请求所花费的时间,从客户端测量到的时间可能会稍长一些。想象如果服务器上只有一个 CPU 核心在逐个地在处理请求,如果每个请求花费 15 毫秒的话,那么每秒可以处理 66 个请求,也就是我们前面提到的 66 QPS;而如果都是复杂的请求,每个需要 30 毫秒的话,那么服务器就只有 33 QPS 了。可以看到在处理能力不变的情况下(只有一个核心),响应时间越高,QPS 就越低。又如果在响应时间不变的情况下,如果我们增加一个 CPU,QPS 就会翻倍,这三者之间的关系可以简单地描述成:吞吐量(QPS)= 并发数/平均响应时间[一个系统吞吐量通常由QPS(TPS)、并发数两个因素决定,每套系统这两个值都有一个相对极限值,在应用场景访问压力下,只要某一项达到系统最高值,系统的吞吐量就上不去了,如果压力继续增大,系统的吞吐量反而会下降,原因是系统超负荷工作,上下文切换、内存等等其它消耗导致系统性能下降]。
其实 CPU 的数量就是并发最基本的概念,即有多少个 CPU 在工作。当然在实际的服务器端环境中,我们在 CPU 的基础上建立起了进程、线程、协程这样复杂的抽象、通过异步的 IO 提高 CPU 的利用率 —— 当需要从硬盘或网络读取数据时,CPU 会去做其他工作,所以并发和 CPU 的比值会比 1 高一些,IO 越多,这个比值会越高。
这时我们可以观测到的并发数就是服务器在同时处理多少个请求,也即「并发连接数」。对于 Web 后端的场景来说(而不考虑**等长链接的场景),我们希望尽快地给客户端响应,所以请求在服务器端花费的几十毫秒中每一毫秒都是必不可少的:可能是在进行计算、也可能是在向磁盘或网络读写数据,都在占用着服务器的资源,因此并发依然是衡量服务器负荷和处理能力的关键指标。
除了并发本身,我们还经常提到「最大并发」的概念,最大并发就是在单位时间(通常是一天)里并发最高的那一刻有多少个 CPU 在为你工作。大部分应用的请求量并不是均匀地分布在一天中的,因为用户们往往会集中在傍晚的几个小时中使用手机,这些时段中的请求量要远远高于凌晨。所以人人都希望在傍晚得到更多的计算能力,但遗憾的是这些计算能力需要原子世界中的 CPU 去支持,你不可能在傍晚购买一批服务器然后在凌晨下掉(当然,这其实是云计算要解决的问题),所以为了支撑傍晚的高并发,我们必须去准备那么多的服务器、必须在凌晨让很多服务器闲置,因此其实我们只关心一天中最高的并发数 —— 这代表了我们需要采购多少硬件资源。
系统吞吐量评估:
我们在做系统设计的时候就需要考虑CPU运算、IO、外部系统响应因素造成的影响以及对系统性能的初步预估。而通常境况下,我们面对需求,
我们评估出来的出来QPS、并发数之外,还有另外一个维度:日PV。
通过观察系统的访问日志发现,在用户量很大的情况下,各个时间周期内的同一时间段的访问流量几乎一样。比如工作日的每天早上。只要能
拿到日流量图和QPS我们就可以推算日流量。
QPS:
每秒查询率(Query Per Second) ,每秒的响应请求数,也即是最大吞吐能力。
QPS = req/sec = 请求数/秒
QPS统计方式 [一般使用 http_load 进行统计]
QPS = 总请求数 / ( 进程总数 * 请求时间 )
QPS: 单个进程每秒请求服务器的成功次数
峰值QPS:
原理:每天80%的访问集中在20%的时间里,这20%时间叫做峰值时间
公式:( 总PV数 * 80% ) / ( 每天秒数 * 20% ) = 峰值时间每秒请求数(QPS)
PV:
访问量即Page View, 即页面浏览量或点击量,用户每次刷新即被计算一次
单台服务器每天PV计算
公式1:每天总PV = QPS * 3600 * 6
公式2:每天总PV = QPS * 3600 * 8
//屏蔽单个ip访问
deny IP;
//允许单个ip访问
allow IP;
//屏蔽所有ip访问
deny all;
//允许所有ip访问
allow all;
//屏蔽整个段即从123.0.0.1到123.255.255.254访问的命令
deny 123.0.0.0/8
//屏蔽IP段即从123.45.0.1到123.45.255.254访问的命令
deny 124.45.0.0/16
//屏蔽IP段即从123.45.6.1到123.45.6.254访问的命令
deny 123.45.6.0/24
//如果你想实现这样的应用,除了几个IP外,其他全部拒绝,
//那需要你在guolv_ip.conf中这样写
allow 1.1.1.1;
allow 1.1.1.2;
deny all;
1.显示出ip
awk ‘{print $1}’ access.log |sort |uniq -c|sort -n
2.根据显示的ip
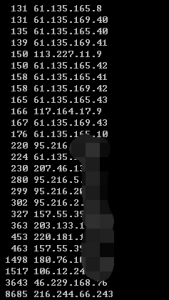 例如216.244.66.243这个IP,查询该ip :https://db-ip.com/216.244.66.243
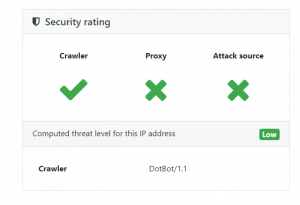 发现该ip为正常爬虫,放之.
同理,61.135.165.41得到的结果是
| Attack type | Fake crawler |
|---|
,同时发现该段ip不止一个,伪造的爬虫.
4,在Nginx的conf的目录下新建blackip.conf,根据规则输入需要过滤的ip或者IP段,然后在Nginx.conf里面加入,include blackip.conf
5./data/nginx/sbin/nginx -t //测试配置文件正确性
/data/nginx/sbin/nginx -s reload 重新加载