1.ctrl+alt+shift+s
2.选择8
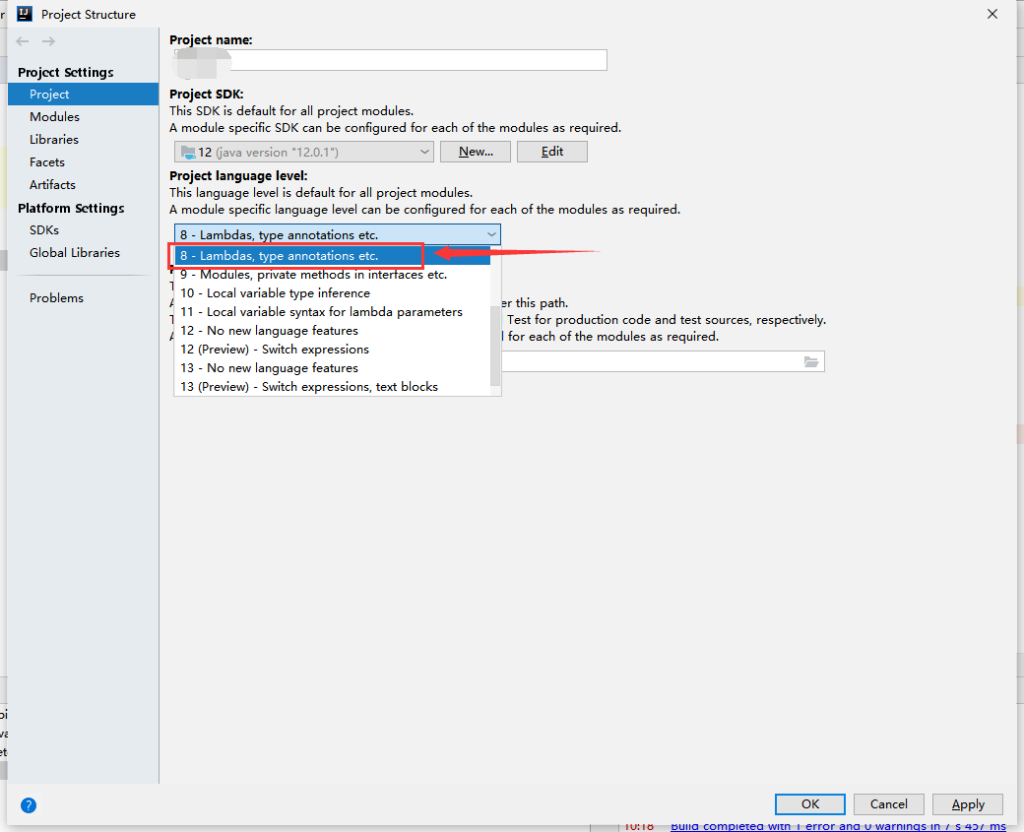
1.ctrl+alt+shift+s
2.选择8
c# 获取网页信息 url
string uri1 = “http://www.hscode.net/Goods/GetHsCodeInfo/?hscode=” + hscode;
var request = WebRequest.Create(uri1);
request.Method = “GET”;
var response = request.GetResponse();
using (var stream = new System.IO.StreamReader(response.GetResponseStream()))
{
var content = stream.ReadToEnd();//获取到远程的页面字符串
}
select name
from sysobjects o, syscomments s
where o.id = s.id
and text like '%Extent1%'
--and o.xtype = 'P'
或者
 SELECT OBJECT_NAME(id) AS 存储过程,
        id
 FROM syscomments
 WHERE id IN (
                 SELECT OBJECT_ID(name) FROM dbo.sysobjects WHERE xtype = 'P' --存储过程为P
             )
       AND text LIKE '%FieldName%' --关键字
 GROUP BY id;
xtype:对象类型。可以是下列对象类型中的一种: C = CHECK 约束 D = 默认值或 DEFAULT 约束 F = FOREIGN KEY 约束 L = 日志 FN = 标量函数 IF = 内嵌表函数 P = 存储过程
PK = PRIMARY KEY 约束(类型是 K) RF = 复制筛选存储过程 S = 系统表 TF = 表函数 TR = 触发器 U = 用户表 UQ = UNIQUE 约束(类型是 K) V = 视图 X = 扩展存储过程
例如:
select b.name
from iqsys.dbo.syscomments a, iqsys.dbo.sysobjects b
where a.id=b.id and b.xtype=’p’ and a.text like ‘%黑名单%’
order by name
umount /home
lvreduce -L 200G /dev/mapper/centos-home
lvextend -L 200G /dev/mapper/centos-root
xfs_growfs /dev/mapper/centos-root
xfs_growfs /dev/mapper/centos-home
QL去除回车符,换行符,空格和水平制表符,参考下面语句,一般情况是SQL接受富文本或是textarea的内容。在数据库接收到这些数据之后,还是对其做一些处理。
REPLACE(REPLACE(REPLACE(REPLACE([fieldName],CHAR(13),”),CHAR(10),”),CHAR(9),”),’ ‘,”)
其中:
char(9) 水平制表符
char(10) 换行
char(13) 回车
去掉空格
replace(‘字段’,’ ‘,”)
去掉回车换行符号
replace(‘字段’,char(13)+char(10),”)
工具–宏–visual basic编辑器–插入模块–拷贝以下内容,
然后在表格里面填上公式 【=除汉字(A1)】,A1是“E2300中国3200S”等所在的单元格
Function 除汉字(rng As Range)
s = Len(rng.Text)
For i = 1 To s
txt = StrConv(Mid(rng.Text, i, 1), vbNarrow)
txt2 = StrConv(Mid(rng.Text, i, 1), vbWide)
If txt <> txt2 Then
除汉字 = 除汉字 & Mid(rng.Text, i, 1)
Next i
End Function
使用“ MediaCreationTool ”安装介质创建程序下载 Windows 10(如果您已经下载了 ISO 文件或者创建了 U盘可以直接进行步骤1中的操作):
启动 “ MediaCreationTool ”程序,阅读并同意软件许可协议:
下载完成后继续下面的操作:
步骤1

按下 键(Windows 徽标键 +X键),点击“命令提示符(管理员)”,复制以下命令并在命令提示符中点击鼠标右键,点击“粘贴”,随后按回车键(Enter)执行:
| reg add “HKEY_LOCAL_MACHINE\SOFTWARE\Microsoft\Windows NT\CurrentVersion” /v EditionID /t REG_SZ /d Core /f |
当显示“操作成功完成”后继续进行步骤2中的操作
步骤2
| setup.exe /pkey TX9XD-98N7V-6WMQ6-BX7FG-H8Q99 |
将打开Windows 10安装程序,然后开始安装。命令将安装与密钥相匹配的版本(图2)——Windows 10 家庭版(Home)
因为业务需要,DOM元素的ID被命名为“INDEX: 2016.09.11”,执行JQuery的DOM查询时,提示如下错误
Uncaught Error: Syntax error, unrecognized expression: [id=INDEX: 2016.09.11]
var rowId = ‘INDEX: 2016.09.11’,
view = document.getElementById(rowId),
// 将Element对象转换为JQuery对象
$view = $(view);
// 毫无疑问,结果返回1
alert($view.length)
2解决方法:属性选择器
利用id属性选择器也可以解决此类问题,只不过略微需要添加点技巧,如下:
var rowId = ‘INDEX: 2016.09.11’;
// 依旧提示unrecognized expression表达式错误
alert($(‘[id=’ + rowId + ‘]’).length)
// 将所有的id值用双引号包起来,即可进行识别
// 请注意双引号添加的位置,只在id上进行包裹
文档对象模型(Document Object Model),是W3C组织推荐的处理可扩展置标语言的标准编程接口。简单理解就是HTML DOM 是关于如何获取、修改、添加或删除 HTML 元素的标准。我们用JavaScript对网页进行的所有操作都是通过DOM进行的。
document.getElementById('id')
用法:
1.上下文必须是document。
2.必须传参数,参数是string类型,是获取元素的id。
3.返回值只获取到一个元素,没有找到返回null。
坑~坑坑坑坑坑坑:
1.如果有多个id存在只获取第一个,也就是最先出现的哪一个。一般情况也不会出现同一个ID在页面上出现两次。
2.在IE6、7中会把表单元素的name当做ID值获取到。所以大家在定义这些的时候一定要注意。
3.在IE6、7中不区分大小写。
4.可以直接用元素的ID代表这个元素。(项目中不推荐)ID中包含特殊字符的情况处理:获取ID含有特殊字符的DOM元素
5.通过ID获取元素的上下文只能是document。为什么上下文必须是document呢,因为getElementById这个方法在Document类的原型上,也许你没有听懂,那就继续往下看。
document.getElementsByName('name')
用法:
1.上下文必须是document。
2.必须传参数,参数是是获取元素的name属性。
3.返回值是一个类数组,没有找到返回空数组。
坑~坑坑坑坑坑坑:
1.获取的结果是一个类数组,不是数组。
2.在IE浏览器中只能获取到表单元素,当然我们一般也只用它获取表单元素,从ie10开始可以不只是表单元素。
3.上下文只能是document,原因同getElementById。
document.getElementsByTagName('p');
var oDiv = document.getElementById('divId');
oDiv.getElementsByTagName('p');
用法:
1.上下文可以是document,也可以是一个元素,注意这个元素一定要存在。
2.参数是是获取元素的标签名属性,不区分大小写。
3.返回值是一个类数组,没有找到返回空数组。
坑~坑坑坑坑坑坑:
1.获取的结果是一个类数组。
2.上下文不必须是document了,因为getElementsByTagName方法在不仅在Document类的原型上也在Element类的原型上,所以document和元素都可以使用这个方法。如果还不懂我在文章最后会再解释一下。
用法(和getElementsByTagName类似):
1.上下文可以是document,也可以是一个元素。
2.参数是元素的类名。
3.返回值是一个类数组,没有找到返回空数组。
坑~坑坑坑坑坑坑:
1.获取的结果是一个类数组。
2.IE8以及以前版本不兼容。真可惜这么好用的方法不兼容。
document.documentElement是专门获取html这个标签的。
document.body是专门获取body这个标签的。
用法:
1.上下文可以是document,也可以是一个元素。
2.参数是选择器,如:”div .className”。
3.返回值只获取到一个元素。
坑~坑坑坑坑坑坑:
这个方法不兼容IE7以及以前版本,现在似乎也没有考虑IE7兼容的公司了。
用法同querySelector类似:
1.上下文可以是document,也可以是一个元素。
2.参数是选择器,如:”div .className”。
3.返回值是一个类数组。
坑~坑坑坑坑坑坑:
同querySelector,不兼容IE7。
拿div举栗子,div是HTMLDivElement类的一个实例,document是HTMLDocument 的实例。
他们的继承关系:
HTMLDivElement > HTMLElement > Element > Node > EventTarget
HTMLDocument > Document > Node > EventTarget
我们都知道子类继承父类,子类就可以使用父类的属性和方法。
他们相同的继承关系是Node和EventTarget,也就是说他们都可以使用Node和EventTarget上的方法。
如Node上的nodeName、parentNode等,和EventTarget上的addEventListener等。
getElementById只在Document类的原型上,HTMLDivElement 没有继承Document类,所以div不能使用getElementById方法。
getElementsByTagName即在Document类的原型上也在Element类的原型上,所以div和document都可以使用getElementsByTagName方法。
其它同理。
在需要搜索的内容前面加~,表示精确搜索